TII, BAE Lehçesini ve Kültürel Nüansları Hedefleyen Yeni Yapay Zeka Modeli Falcon-Emirati-7B'yi Duyurdu
Teknoloji İnovasyon Enstitüsü (TII) araştırma ekibi, BAE'nin günlük konuşma dilini, deyimlerini ve kültürel bağlamını yerel bir konuşmacı gibi işleyebilen Falcon-Emirati-7B modelini duyurdu. Model, Alyah benchmark testinde %84.83 başarı elde etti.

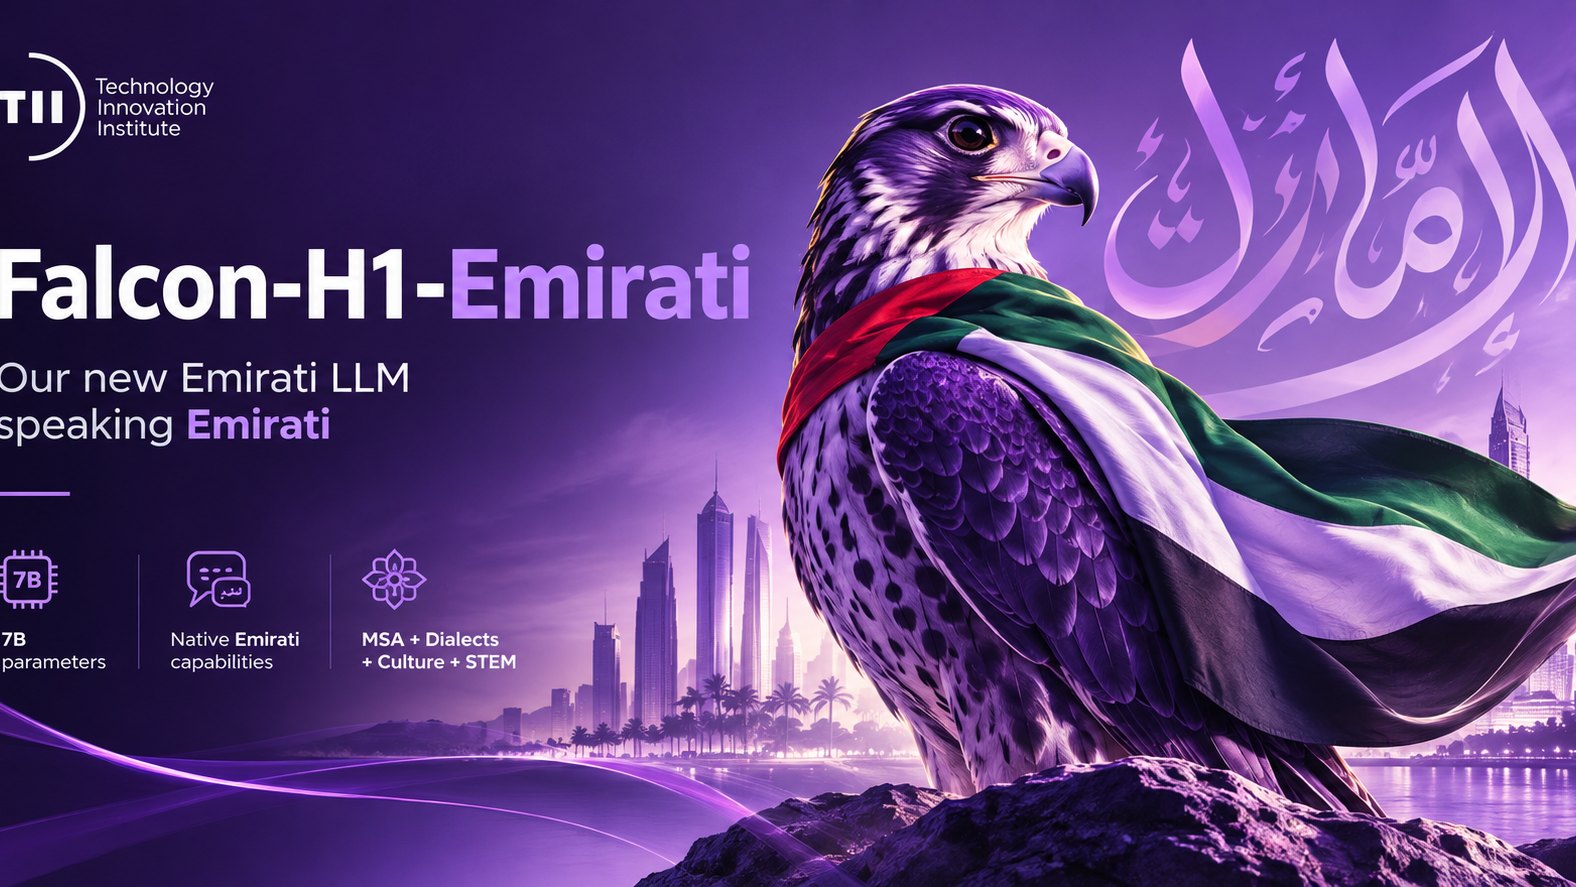
Teknoloji İnovasyon Enstitüsü (TII) araştırmacıları, Arap dilinin karmaşık yapısı ve bölgesel lehçe çeşitliliğine odaklanan yeni büyük dil modeli Falcon-Emirati-7B'yi resmi olarak tanıttı. 6 Ekim 2026 tarihinde paylaşılan bilgilere göre model, haberlerde ve ders kitaplarında yer alan Modern Standart Arapça (MSA) ile günlük yaşamda kullanılan Körfez lehçeleri arasındaki ifade ve anlam uçurumunu kapatmayı amaçlıyor.
Arapça, tek bir çatı altında yaşayan bir diller ailesi olarak değerlendiriliyor. BAE'deki günlük sohbetler, mizah, müzakereler ve hikaye anlatımı kendine özgü kelime dağarcığına ve ritme sahip olan BAE lehçesinde gerçekleşiyor. Özellikle nabati şiiri, yerel atasözleri ve kısa anekdotlar kelimesi kelimesine yapılan çevirilerde anlamını yitirebiliyor. Sadece standart Arapçaya vakıf olan bir model, bu tür kültürel katmanları kaçırabiliyor. Falcon-Emirati-7B, bu eksiği gidermek üzere geliştirildi.
Falcon-H1 Hibrit Mimarisi Üzerine Kuruldu
Shaikha Alsuwaidi, Omar Saif Alkaabi, Maitha Alhammadi ve Hakim Hacid liderliğindeki TII ekibi, projede sıfırdan başlamadı. Model, yılın başlarında dil alanında yeni standartlar belirleyen Falcon-H1-Arabic ailesi üzerine inşa edildi. Falcon-H1 hibrit mimarisini kullanan bu aile; her bloğun içinde paralel olarak çalışan State Space Models (Mamba) ve Transformer dikkat mekanizmalarını birleştiriyor. Bu yapı, uzun dizilerde Mamba'nın doğrusal zaman verimliliğini sağlarken, Arapça gibi biçimbilimsel açıdan zengin diller için kritik olan uzun menzilli bağımlılıklarda Transformer hassasiyetini koruyor.
3B, 7B ve 34B parametre ölçeklerine sahip aile, 128K ile 256K arasında değişen bağlam pencerelerini destekliyor. TII ekibi, eğitim ve çıkarım maliyetleri ile derinlemesine kültürel kavrayış dengesini göz önünde bulundurarak 7B varyantını seçti. 34B modeli maliyet açısından bir sohbet modeli için verimsiz kalırken, 3B modeli ise hedeflenen kültürel derinlik için yeterli baş üstü payı bırakmıyordu.
Yerel Lehçe Uyarlamasındaki Veri Stratejisi
Genel bir Arapça modelini BAE lehçesi uzmanına dönüştürmek, yazılı verinin azlığı, mecazi anlatımlar ve standart bir rehberin bulunmaması nedeniyle ciddi zorluklar barındırıyordu. TII ekibi bu sorunu aşmak için üç bileşenli özel bir veri hattı oluşturdu:
* Otantik BAE Lehçesi Web Verileri: Çevrilmemiş veya translere edilmemiş, doğrudan yerel kullanıcıların web sitelerinde ve forumlarda kullandığı doğal ifadeler tarandı. * BAE Kültürüne Dair MSA Verileri: Yerel gelenekler, değerler, tarih ve sosyal normlar hakkında standart Arapça materyaller eklenerek modelin kavramsal altyapısı güçlendirildi. * Sözlük Kurallarıyla Desteklenen Sentetik Veri: Eksik kalan alanları kapatmak için BAE kelime dağarcığına ve dilbilgisi kurallarına sıkı sıkıya bağlı sentetik veriler üretildi.
Alyah Benchmark Testi ve Değerlendirme Sonuçları
Modelin performansını ölçmek için hem insan değerlendirmesine hem de otomatik testlere başvuruldu. Yerel BAE konuşmacıları, modelin çıktılarının tonunu, doğallığını ve kültürel uygunluğunu manuel olarak inceledi. Nicel takip için ise TII tarafından geliştirilen Alyah benchmark'ı kullanıldı.
1.173 örnekten oluşan tamamen yerel çoktan seçmeli Alyah testi; selamlaşmalar, görgü kuralları, mecazi dil, miras bilgisi ve şiir kategorilerini kapsıyor. Bu test sonuçlarına göre Falcon-Emirati-7B, karşılaştırılan diğer tüm Arapça ve çok dilli modelleri geride bırakarak %84.83 skora ulaştı.
Çoktan seçmeli testlerin yanı sıra, açık uçlu üretim yeteneklerini test etmek amacıyla Gemini 3.7 Flash hakemliğinde LLM-as-Judge değerlendirmesi de gerçekleştirildi. Elde edilen bulgular, yapay zeka modellerinde lehçe yetkinliğinin yalnızca model boyutunu büyütmekle kazanılmadığını, aksine bilinçli bir bölgesel veri ve değerlendirme stratejisi gerektirdiğini ortaya koyuyor.
 Bilimsel Yapay Zeka Modelleri İçin Çığır Açan Çözüm: ReRoute Çerçevesi TanıtıldıAI Modelleri · 09:39
 Reflection AI, Çinli Açık Modellerle Rekabet Edecek Yeni Modeli Beam’i TanıttıAI Modelleri · 08:18
 OpenAI, ChatGPT’nin Görsel Üretim Özelliğine Reklam EkliyorAI Modelleri · 04:20