Modern Bilgisayar ve Yapay Zeka Testlerinde Benchmark Tartışmaları: Ham Skorlar Gerçeği Yansıtıyor mu?
Bilgisayar donanım performansını ölçen geleneksel kıyaslama araçları ile yapay zeka modellerinin etkinlik testleri arasındaki paralellikler ve sektördeki güncel değerlendirme tartışmaları ele alınıyor.

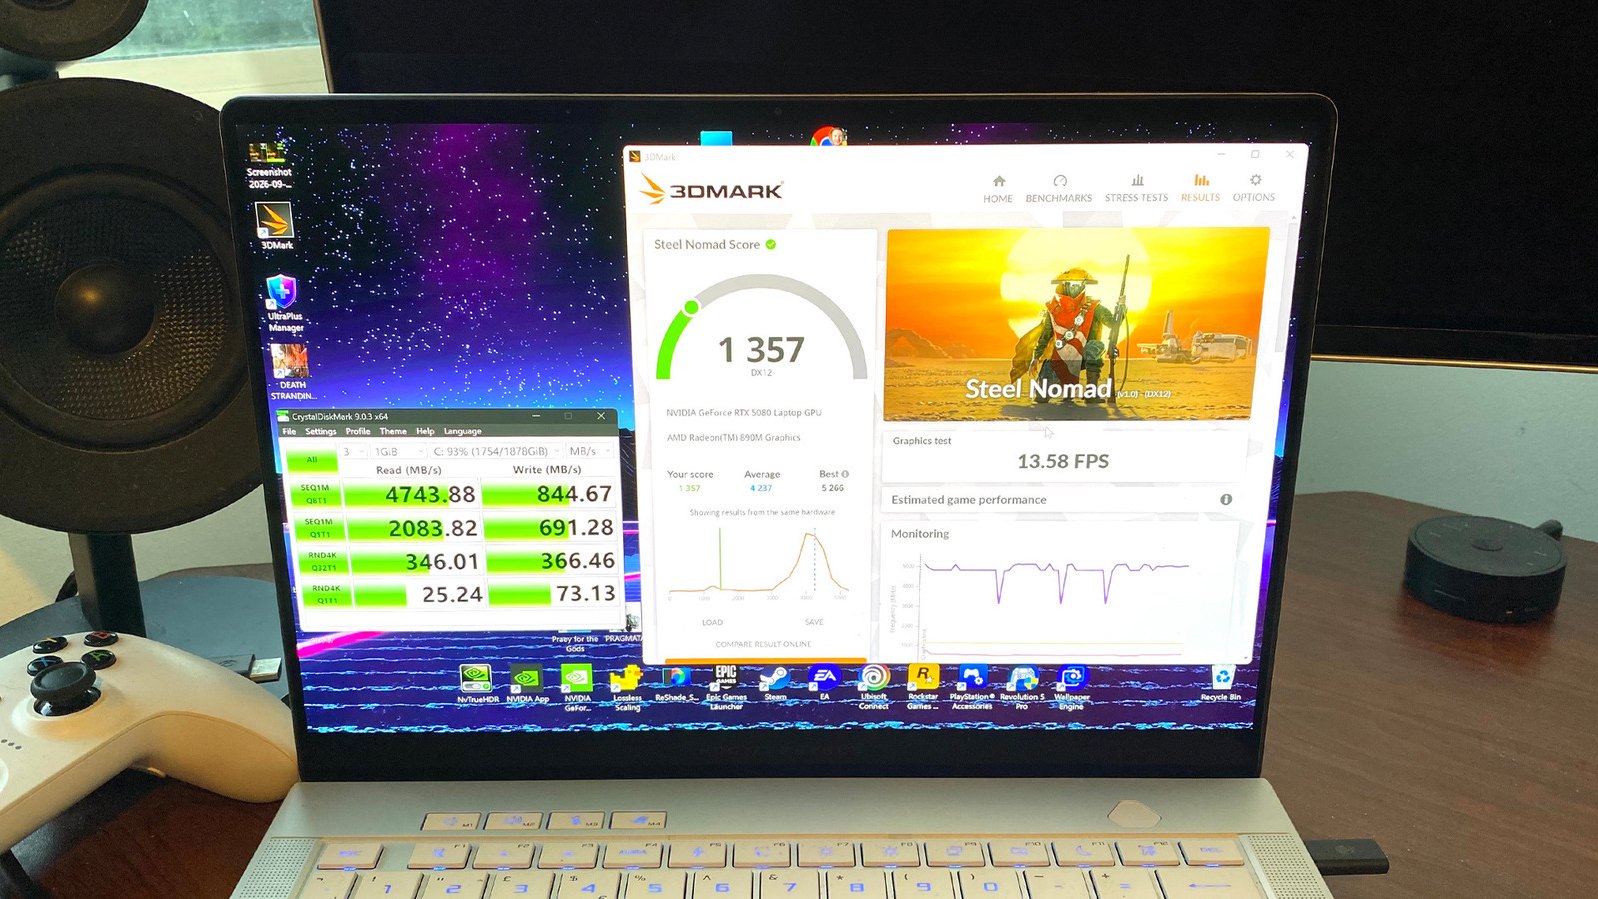
Bilgisayar sistemlerinin, işlemcilerin ve modern yapay zeka modellerinin kapasitesini ölçmek için kullanılan kıyaslama araçları, teknoloji dünyasında güvenilirlik tartışmalarının odağında yer almaya devam ediyor. Donanım bileşenlerinin sınırlarını zorlayan sentetik testler ile yapay zeka ekosistemindeki model değerlendirmeleri, ham skorların gerçek dünya performansını ne ölçüde yansıttığı konusunda benzer soru işaretlerini beraberinde getiriyor.
Donanım Dünyasında Temel Benchmark Araçları
Ekim 2026 döneminde yayımlanan teknik rehberler, kullanıcıların ekran kartı, işlemci ve depolama birimlerinin performansını doğru okuyabilmesi için erişilebilir araçların önemine dikkat çekiyor. Grafik kartı testlerinde sektör standartlarından biri olan 3DMark, kullanıcıların sistemlerini Solar Bay, Time Spy ve Speed Way gibi modlarla test etmesine olanak tanırken, benzer donanıma sahip diğer oyuncuların skorlarıyla kıyaslama yapma imkanı sunuyor.
Bunun yanı sıra UNIGINE 2 motorunu kullanan Superposition, ağır aydınlatma ve görsel efekt yükleri altında ekran kartının saat hızlarını ve sıcaklık değişimlerini izlemek için tercih ediliyor. İşlemci tarafında ise çok çekirdekli render performansını test etmek ve termal kısıtlama gibi potansiyel soğutma sorunlarını tespit etmek için Cinebench güvenli bir laboratuvar standardı sunuyor. Depolama birimlerinde ise CrystalDiskMark açık kaynaklı yapısıyla sıralı okuma ve yazma hızlarını pratik bir şekilde raporluyor.
Oyun İçi Testler ve Gerçek Dünya Performansı
Sentetik test yazılımları sistemin taban seviyesindeki donanım sağlığını ve olası VRAM yetersizliklerini veya yanlış güç ayarlarını erkenden fark etmeyi sağlasa da, uzmanlar gerçek dünya deneyimi için oyun içi araçların daha net sonuçlar verdiğine işaret ediyor. Örneğin, Forza Horizon 6 ve Cyberpunk 2077 gibi yapımların dahili benchmark araçları; GPU kullanımı, CPU verimliliği ve kare hızı grafiklerini doğrudan kalabalık sahneler üzerinden ölçerek grafik ayarlarının etkisini anında görmeyi mümkün kılıyor.
Yapay Zeka Model Testlerindeki Güvenilirlik Tartışmaları
Donanım testlerindeki bu doğruluk arayışı, yapay zeka ve büyük dil modelleri pazarında da benzer bir yankı buluyor. Yapılan sektör analizleri ve eleştiriler, OpenAI ve Anthropic gibi öncü yapay zeka şirketlerinin yeni nesil modelleri için yayımlanan benchmark skorlarının her zaman günlük kullanım senaryolarındaki gerçek performansı yansıtmadığını ortaya koyuyor. Laboratuvar ortamında optimize edilmiş yüksek test skorlarının, pratik iş akışlarında aynı verimliliği sunamaması, teknoloji ekosisteminde değerlendirme kriterlerinin yeniden masaya yatırılmasına neden oluyor.
İster oyuncu bilgisayarlarının termal sınırlarını zorlayan bir donanım testi olsun, isterse yapay zeka modellerinin kapasitesini ölçen kıstaslar olsun; uzmanlar ham skorların tek başına mutlak bir başarı kriteri olarak görülmemesi ve sistem kararlılığı ile desteklenmesi gerektiğinde hemfikir.
 Telekom Operatörleri Yapay Zeka Stratejilerini Açık Kaynak Modeller Üzerine KuruyorAI Modelleri · 20:08
 Anthropic, Kurumsal Yapay Zeka Hamlesi İçin 100 Milyon Dolarlık Claude Frontier Academy Programını BaşlattıAI Modelleri · 18:55
 Mistral, 1 Trilyon Parametreli Yeni Açık Ağırlıklı Modeli ‘Le Chonk’u DuyurduAI Modelleri · 17:34